
조건부 변분 오토인코더를 이용한 연료전지 균일 전류분포 운전조건 탐색
© The Korean Hydrogen and New Energy Society
This is an Open Access article distributed under the terms of the Creative Commons Attribution-Non-Commercial 4.0 International License (CC BY-NC 4.0, https://creativecommons.org/licenses/by-nc/4.0/), which permits non-commercial use, sharing, adaptation, distribution, and reproduction in any medium or format, provided the original work is properly cited.
Abstract
Many operating conditions of a polymer electrolyte membrane fuel cell (PEMFC) can give the same current distribution, but an inverse neural network returns only one of them. Using 189 segmented-cell runs of a previous study, a conditional variational autoencoder generates 40,000 candidate conditions for a uniform current distribution, and a forward multi-layer perceptron screens them. The 1,302 accepted conditions share 60℃ and a cathode relative humidity of 60-80% but split into two cathode-stoichiometry families near 2 and near 3, whereas a deterministic inverse network returns a physically impossible condition.
Keywords:
Fuel cell, Current distribution, Segmented cell, Inverse design, Conditional variational autoencoder, Neural network키워드:
연료전지, 전류분포, 세그먼트 셀, 역설계, 조건부 변분 오토인코더, 신경망1. 서 론
고분자전해질 연료전지(Polymer Electrolyte Membrane Fuel Cell, PEMFC)는 낮은 운전 온도와 높은 출력 밀도 덕분에 수송용과 건물용 전원으로 보급이 넓어지고 있다. 그러나 실제 셀 안에서는 반응물 농도, 막 함수율, 온도가 유로를 따라 변하므로 전류가 활성 면적 전체에 고르게 흐르지 않는다1). 전류가 몰리는 곳에서는 발열과 물 생성이 늘어 플러딩이 생기고, 전류가 낮은 곳에서는 막이 마르거나 반응물이 부족해진다. 이런 불균일은 촉매층과 막-전극 접합체의 국부 열화로 이어지므로 성능과 내구성 양쪽에서 중요한 문제이며2), 국내에서도 부하 변동이 스택 수명에 미치는 영향3)을 비롯하여 셀 전체에 고른 운전 환경을 만드는 연구가 이어지고 있다. 국부 전류분포를 직접 재는 수단이 세그먼트 셀이다. 분리판이나 집전판을 여러 조각으로 나누고 조각마다 전류를 재는 방식으로, 여러 형식의 세그먼트 셀이 제안되어 왔다4,5). 실험과 수치해석에 따르면 낮은 습도에서는 입구 쪽 전류가 떨어지고6), 높은 습도와 낮은 유량에서는 출구 쪽이 떨어지며, 온도와 압력은 이 두 경향의 균형을 옮긴다7). 곧 균일한 전류분포는 서로 반대 방향으로 작용하는 여러 운전변수가 맞물릴 때 얻어지며, 그 조합이 하나뿐이라고 볼 이유는 없다.
운전조건과 전류분포의 관계를 자료에서 직접 배우는 데에는 인공신경망이 널리 쓰인다. PEMFC 성능 예측8)과 고체산화물 연료전지 스택의 성능 예측9)에 적용되어 왔고, 국내 연료전지 연구 동향에서도 데이터 기반 예측과 진단은 한 축으로 자리 잡았다10). Park 등11)은 25개 세그먼트로 나눈 PEMFC의 실험 데이터로 운전조건을 입력받아 세그먼트별 전류를 출력하는 다층 퍼셉트론(Multi-Layer Perceptron, MLP)을 학습하여 국부 전류분포를 3% 이내의 오차로 예측하였다. 나아가 같은 데이터로 입력과 출력을 뒤바꾼 신경망을 학습하고 균일한 전류분포를 입력하여 운전조건을 얻는 방법을 제안하였다. 목표 분포에서 운전조건을 시행착오 없이 바로 얻는다는 점에서, 이 접근은 연료전지 분야에 역설계(inverse design)를 도입한 것이다.
입출력을 뒤바꾼 신경망은 목표 하나에 운전조건 하나를 내므로 빠르고 간결하다. 다만 앞 문단에서 본 대로 전류분포에서 운전조건으로 가는 관계는 일대다이다. 해가 여럿인 자료로 결정론적 신경망을 학습하면 모델은 여러 해의 평균 부근에 출력 하나를 두게 되고, 그 평균이 반드시 해인 것은 아니다. 또한 해가 어떤 범위에 걸쳐 있는지, 얻은 조건이 학습 자료가 뒷받침하는 범위 안에 있는지는 단일해만으로는 알 수 없다. 이 문제에는 목표 하나에 대한 해의 분포를 배우는 조건부 생성 모델이 알맞다. 조건부 변분 오토인코더(Conditional Variational Autoencoder, CVAE)는 잠재변수를 두어 같은 목표에 대해 잠재변수에 따라 다른 출력을 만든다. 생성적 적대 신경망과 달리 손실 함수가 명시적이어서 학습이 안정적이며, 본 연구처럼 자료가 수백 개 수준인 문제에도 쓸 수 있다.
본 연구는 선행연구11)와 같은 세그먼트 셀 데이터로 균일 전류분포 운전조건을 점이 아닌 집합으로 구한다. 먼저 운전조건과 전류분포 사이의 일대다 관계를 자료 안에서 확인한다. 다음으로 전류분포를 조건으로 운전조건을 생성하는 CVAE 역모델을 학습하고, 균일 분포를 넣어 운전조건 후보를 많이 만든 뒤, 운전조건에서 전류분포를 예측하는 정방향 MLP로 후보를 다시 평가하여 균일도가 높은 후보를 고른다. 끝으로 같은 정방향 모델로 결정론적 역방향 MLP의 답을 평가하여 비교한다.
2. 연구 방법
2.1 세그먼트 연료전지 실험 데이터
본 연구는 새 실험을 하지 않고 선행연구11)가 확보한 세그먼트 셀 데이터를 그대로 사용한다. 시험 장치에서 건조한 수소와 공기는 질량유량제어기로 유량을 맞춘 뒤 버블러형 가습기를 지나 셀에 들어가며, 가습기 온도로 이슬점을 조절한다. 셀 압력은 양극 출구의 압력 조절기로 맞추고 부하는 전자부하기로 정전류 방식으로 건다. Fig. 1은 애노드 분리판으로, 활성 면적 25 cm2를 서로 절연된 1 cm2 세그먼트 25개로 나누었다. 유로는 5패스 4턴의 사형 유로이며 세그먼트 번호는 애노드 유로를 따라 입구에서 출구 순으로 매긴다. 세그먼트별 전류는 분리판 뒤의 인쇄회로기판 집전판과 홀 효과 센서 25개로 측정한다. 모든 실험은 전류밀도 1 A/cm2, 곧 총 전류 25 A의 정전류에서 수행되었으므로 세그먼트 전류는 평균 1 A를 기준으로 한 편차로 읽을 수 있다.
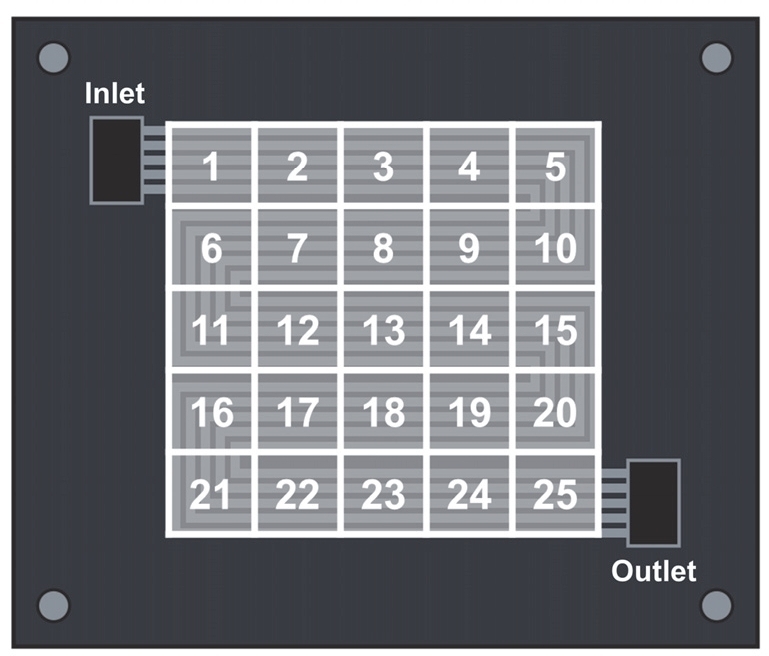
Segmented anode bipolar plate with five-pass serpentine flow field
운전변수는 셀 온도, 압력, 애노드와 캐소드의 이슬점, 수소와 공기의 화학양론비(Stoichiometric Ratio, SR) 여섯 가지이다. 측정 조건은 Table 1과 같이 세 경우로 나뉜다. 30∼50℃에서는 이슬점을 셀 온도와 같게 두고 SR 세 조합을 측정하였고, 60℃에서는 이슬점 30℃와 60℃에서 SR 아홉 조합을, 40℃와 50℃에서 세 조합을 측정하였다. 자료는 189회의 측정 회차로 이루어져 있고, 회차마다 정상상태 500개 표본이 담겨 있다. 회차 안에서 표본이 흔들리는 폭은 평균 0.0005로 회차 사이의 차이보다 두 자릿수 작으므로, 회차마다 500개 표본을 평균한 값 하나를 학습 자료로 쓴다. 189회차는 공칭 운전조건 133개에 해당하며 일부 조건은 두 차례 이상 반복 측정되었다.

Experimental cases of the data set
2.2 입력과 출력
입력 벡터 x는 압력 P [bar], 셀 온도 T [℃], 수소와 공기의 SR, 애노드와 캐소드의 상대습도(Relative Humidity, RH)의 여섯 변수를 식 (1)과 같이 늘어놓은 것이다.
| (1) |
여기서 상대습도는 식 (2)와 같이 이슬점 Tdew에서의 포화증기압 psat과 셀 온도 Tcell에서의 포화증기압의 비이며, 1을 넘지 않도록 하였다.
| (2) |
압력과 SR을 10으로, 셀 온도를 100으로 나눈 것은 선행연구11)와 같은 환산으로, 여섯 입력이 모두 0.1∼1 범위의 비슷한 크기가 되게 하여 어느 한 변수가 크기만으로 학습을 지배하지 않게 하기 위한 것이다. 기준값을 자료의 최소⋅최대 대신 상수로 둔 것은 환산한 값에서 물리량을 바로 읽을 수 있고 자료가 더해져도 척도가 바뀌지 않기 때문이다. 자료의 최소⋅최대로 0∼1 범위에 정규화하여 같은 교차검증을 하여도 정방향 모델의 오차는 2.3%로 거의 같았다. 전류밀도는 모든 회차에서 같아 입력에서 제외하였다. 출력은 세그먼트 전류를 상대 편차로 바꾼 잔차이다. 홀 센서 25개의 합이 총 전류와 같아지도록 비례 보정한 뒤, 각 세그먼트 전류를 평균 전류로 나누고 1을 뺀다.
| (3) |
잔차 25개의 표준편차 σ는 전류밀도 1 A/cm2에서 세그먼트 전류의 표준편차(A)와 같다. 본 논문에서 전류분포의 균일도는 이 σ로 나타내며, 완전히 균일한 분포는 σ = 0이다.
2.3 정방향 전류분포 예측 모델
정방향 모델은 운전조건 x(6개)로부터 잔차 r(25개)을 예측한다. 구조는 선행연구11)와 같은 은닉층 10-15-20의 완전연결 MLP(ReLU, Adam, 학습률 0.001)이고 scikit-learn으로 구현하였다. 하이퍼파라미터는 공칭 조건 133개를 5개 묶음으로 나누어 한 묶음의 모든 회차를 검증에 남기는 교차검증으로 정하였다. 반복 측정된 조건이 학습과 검증에 나뉘어 들어가지 않게 하기 위해서이다. 최종 모델은 초기값을 달리하여 10개를 학습하고 예측값의 평균을 쓴다. 본 연구에서 정방향 모델은 예측기이면서 역모델이 내놓은 후보를 평가하는 검증기이기도 하다.
2.4 조건부 변분 오토인코더 역모델
역모델은 전류분포 c(잔차 25개)가 주어졌을 때 운전조건 x(6개)를 생성한다. 결정론적 역모델이 c에서 x로 가는 함수 하나를 배우는 것과 달리, 조건 c 하나에 대해 여러 x를 만들 수 있어야 하므로 잠재변수 z를 둔 CVAE를 쓴다. 인코더는 x와 c를 함께 받아 z의 평균과 분산을 내고, 디코더는 z와 c를 받아 x를 되돌린다. 두 망 모두 은닉층 32-32(ReLU)이며 z는 3차원이다. 학습 목표는 재구성 오차와, 잠재변수의 분포를 표준정규분포에 가깝게 유지하는 항의 합이다.
| (4) |
여기서 β는 두 항의 비중이며 0.1로 두었다. β가 작으면 잠재공간이 정규분포에서 멀어져 표집한 z가 학습되지 않은 영역을 가리키기 쉽고, β가 크면 잠재변수가 무시되어 조건 하나에 출력 하나만 남는다. 학습이 끝나면 디코더에 목표 분포 c와 표준정규분포에서 뽑은 z를 넣어 x를 생성한다. z를 바꿀 때마다 다른 x가 나오므로 목표 하나에 대해 후보를 원하는 만큼 만들 수 있다. 균일 분포는 학습 자료에 없는 목표여서 초기값에 따라 생성 결과가 달라지므로, 초기값을 달리하여 20개를 학습하고 생성 결과를 합쳐 쓴다. 구현에는 PyTorch를 사용하였다. 비교군으로는 입력과 출력을 뒤바꾼 결정론적 역방향 MLP11)(25-20-15-10-6, 이하 결정론적 역MLP)를 같은 자료로 학습하였다.
2.5 균일 전류분포 운전조건의 탐색 절차
Fig. 2는 전체 절차이다. 완전히 균일한 분포 c* = 0(잔차 25개가 모두 0)을 조건으로 역모델 20개에서 각각 z를 2,000개 뽑아 운전조건 후보 40,000개를 만든다. 첫째, 여섯 변수가 모두 학습 자료의 범위 안에 있는 후보만 남긴다. 정방향 모델은 학습 범위 밖에서 근거 없이 외삽하므로 범위 밖 후보는 평가할 수 없기 때문이다. 둘째, 남은 후보를 정방향 모델에 넣어 예측 전류분포의 표준편차 σ̂를 구하고, σ̂가 낮은 5%를 채택한다. 셋째, 채택 후보는 천 개가 넘으므로 k-평균법(k-means clustering)으로 몇 개의 대표 운전조건으로 요약한다. k-평균법은 자료를 미리 정한 k개의 군집으로 나누되, 각 점과 자기 군집 중심 사이의 거리 제곱합이 가장 작아지도록 중심을 반복해서 옮기는 군집화 방법이다. 여섯 변수의 단위가 서로 다르므로 변수마다 범위 안 후보의 평균과 표준편차로 표준화한 좌표에서 거리를 재고, 초기 중심에 따라 결과가 달라지는 것을 피하기 위해 초기값 10개 가운데 거리 제곱합이 가장 작은 결과를 쓴다. 본 연구는 k = 3으로 두고 각 군집에 속한 후보의 평균을 대표 운전조건으로 삼았다. 결정론적 역MLP에 c* = 0을 넣어 얻은 조건도 같은 정방향 모델로 평가한다.
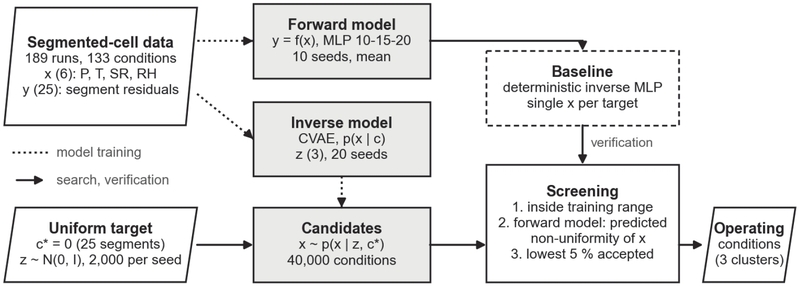
Procedure for finding operating conditions of uniform current distribution
운전조건과 전류분포의 관계가 일대다임은 자료에서 다음과 같이 확인한다. 189회차의 모든 쌍(17,766쌍)에 대해, 두 회차 a와 b의 분포의 거리 dY를 식 (5)와 같이 세그먼트별 잔차 차이의 제곱평균제곱근(Root Mean Square, RMS)으로 정의하고, 조건의 거리 dX를 변수마다 학습 범위로 나눈 여섯 차원 유클리드 거리로 정의한다.
| (5) |
dY의 문턱 0.01 A는 정방향 모델의 잔차 예측 오차(RMS 0.03 A, 3.1절)의 1/3 수준이고 같은 조건을 반복 측정했을 때의 분포 차이(중앙값 0.015 A)보다도 작아, 이보다 가까운 두 분포는 모델로도 측정으로도 구별할 수 없다. 분포의 거리가 0.01 A 미만이고 조건의 거리가 0.5를 넘는 쌍을 “같은 분포를 내는 다른 조건”으로 센다. 문턱을 0.005 A로 좁히면 이런 쌍은 149개, 0.02 A로 넓히면 1,482개로 수는 달라지지만, 조건의 거리와 분포의 거리 사이의 상관이 약하다는 3.2절의 결론은 바뀌지 않는다.
3. 결과 및 고찰
3.1 정방향 모델의 정확도
교차검증에서 정방향 모델의 세그먼트 평균 상대오차는 2.2%였고, 잔차 예측 오차는 RMS 0.03 A였다. 입력에 관계없이 학습 회차의 평균 잔차 패턴을 그대로 내는 상수 예측기의 오차 4.1%보다 뚜렷이 낮으므로, 모델은 운전조건에 따른 분포의 변화를 실제로 학습한 것이다. Fig. 3은 학습에 쓰이지 않은 회차 가운데 오차가 중앙값(1.4%)인 회차(60℃, 이슬점 60℃, 1 bar, SR 1.5/2.0)의 실측 분포와 예측 분포이다. 모델은 이 조건을 본 적이 없는데도 입구에서 출구로 갈수록 전류가 줄어드는 형태와 세그먼트 11, 16의 국부 하락까지 재현한다.
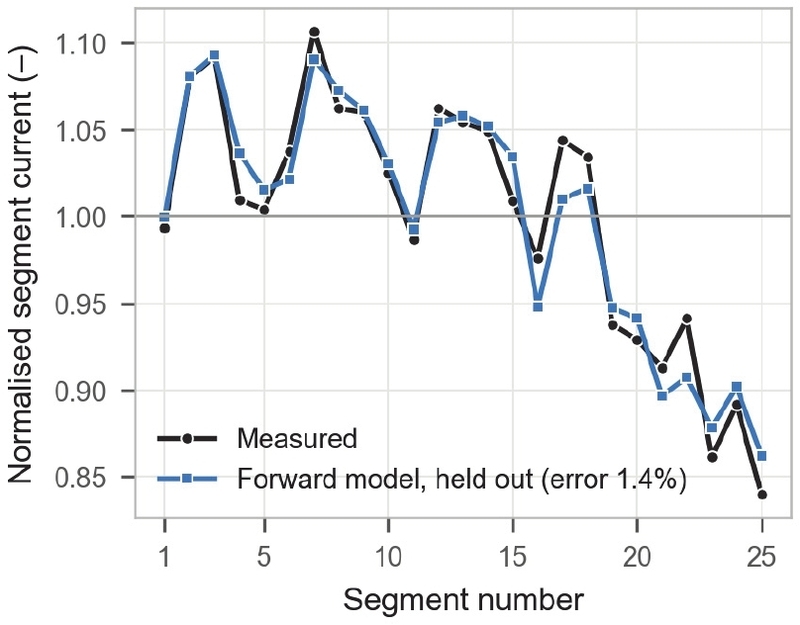
Measured and predicted current distributions of a held-out condition (60℃, dew point 60℃, 1 bar, SR 1.5/2.0)
한 가지 주의할 점은 균일한 분포일수록 모델이 표준편차를 조금 크게 예측한다는 것이다. 잔차 25개가 모두 0에 가까우면 모델이 잔차의 부호까지 맞히기 어렵고, 잔차 오차는 표준편차를 늘리는 쪽으로만 작용하기 때문이다. 실제로 자료에서 가장 균일했던 회차(σ = 0.040 A)의 조건을 넣으면 모델은 0.051 A를 예측한다. 이 편향은 후보들에게 거의 같은 크기로 얹히므로 후보끼리 비교하는 데는 문제가 없으나, 예측 표준편차를 실측값과 직접 견주어서는 안 된다.
3.2 자료에 나타난 다중해
Fig. 4는 189회차의 모든 쌍 17,766개에 대해 조건의 거리와 분포의 거리를 그린 것이다. 둘의 상관계수는 0.39에 그쳐 조건이 멀다고 분포가 멀지 않으며, 분포의 거리가 0.01 A 미만이면서 조건의 거리가 0.5를 넘는 쌍(주황 점)이 460개 있다. 이 쌍들은 같은 조건을 반복 측정했을 때의 차이(중앙값 0.015 A)보다도 가까운 분포를 내면서 조건은 학습 범위의 절반 이상 떨어져 있다. 예를 들어 60℃, 이슬점 60℃, 2 bar, SR 1.2/1.2인 조건과 60℃, 이슬점 50℃, 3 bar, SR 2.0/3.5인 조건은 25개 세그먼트의 분포가 RMS 차이 0.007 A로 거의 같다. 포화 가습에 낮은 유량인 조합과, 습도가 낮은 대신 압력을 높이고 유량을 늘린 조합이 비슷한 막 함수율에 이른 것으로 볼 수 있다. 이런 자료로 학습한 결정론적 역모델은 여러 조건 가운데 하나를 고르거나 그 사이의 값을 낼 수밖에 없다.
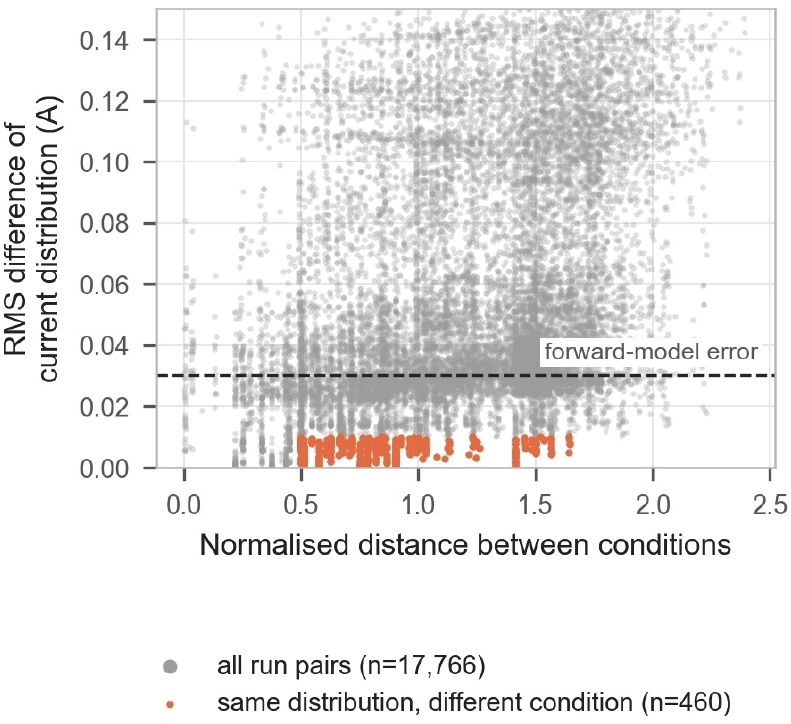
Distance between operating conditions vs. difference of current distribution for all run pairs
3.3 균일 전류분포 운전조건 후보 집합
완전히 균일한 분포를 목표로 생성한 후보 40,000개 가운데 학습 범위 안에 든 것은 26,025개(65%)였다. Fig. 5는 범위 안 후보의 예측 표준편차 분포이다. 최솟값은 0.043 A이고 대부분은 0.05∼0.07 A에 몰려 있다. 낮은 5%에 해당하는 0.052 A 이하의 후보 1,302개를 채택하였다.
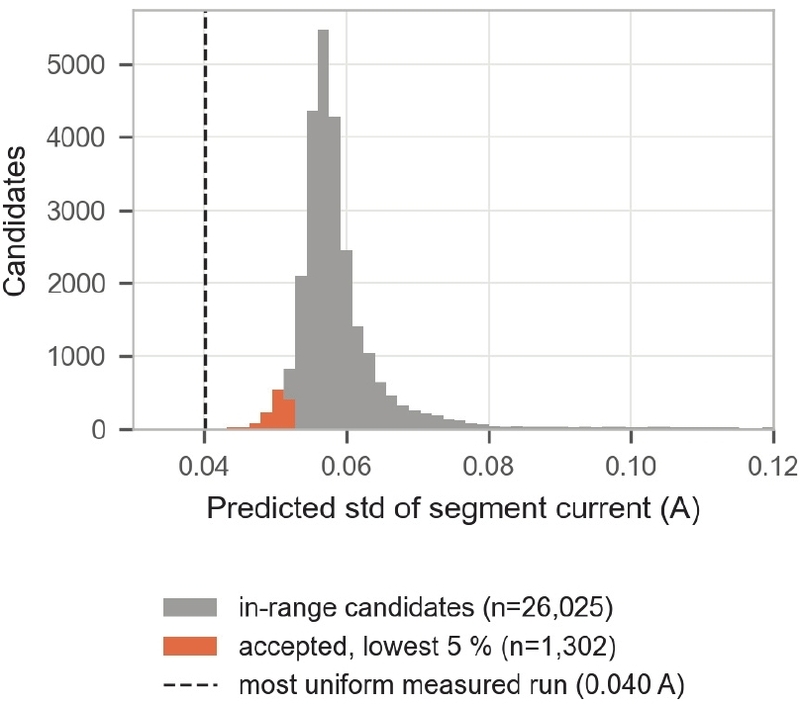
Predicted non-uniformity of the in-range candidates and the accepted 5%
Fig. 6은 채택 후보의 위치이다. 온도는 채택 후보의 90%가 59℃ 이상으로 학습 상한 60℃에 붙어 있었다. 압력은 1.0∼3.0 bar 전체에 걸쳐 있었고, 캐소드 상대습도는 41∼96%에 걸쳐 있으나 60∼80%에 몰렸으며, 캐소드 SR은 2 부근과 3 부근의 두 무리로 갈렸다. Fig. 7은 여섯 변수 각각에 대해 범위 안 후보와 채택 후보의 분포를 비교한 것이다. 채택으로 인해 온도는 60℃로, 상대습도는 60∼80%로 좁혀지고, 압력과 SR은 넓게 남는다. 곧 이 자료의 범위에서 균일한 전류분포를 주는 운전조건은 “60℃, 캐소드 상대습도 60∼80%”를 공유하되 압력과 SR은 여러 값이 가능한 집합이다.
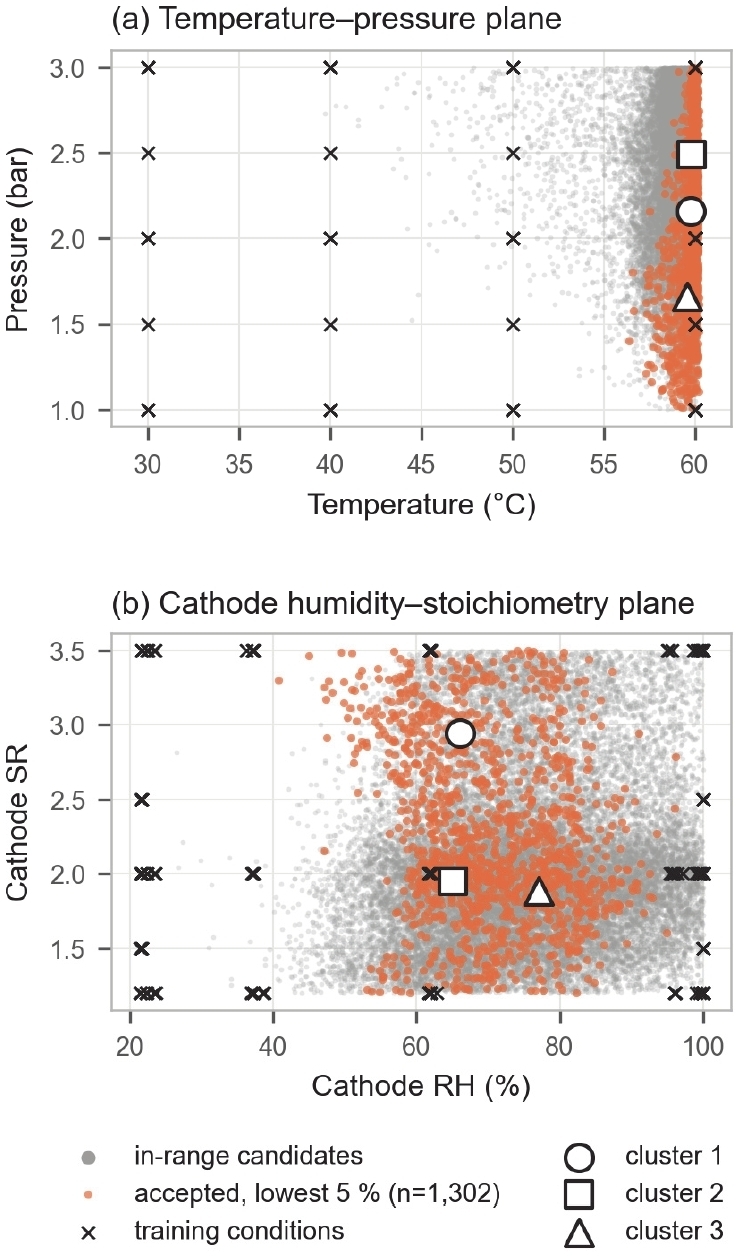
Accepted operating conditions and the three representative conditions
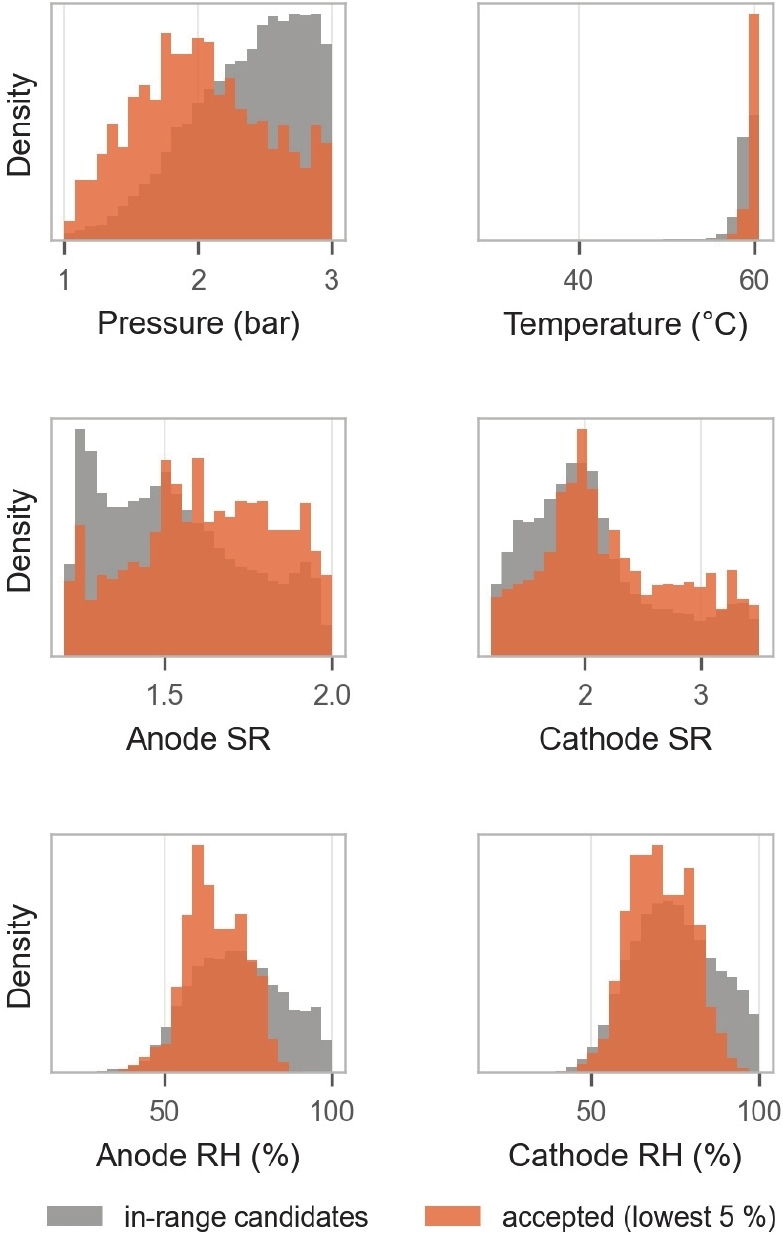
Distributions of the six operating variables: in-range candidates vs. accepted set
k-평균법으로 나눈 세 군집의 중심을 Table 2에 정리하였다. 군집 1은 캐소드 SR 2.9의 높은 유량 계열이고, 군집 2와 3은 캐소드 SR 1.9의 낮은 유량 계열로서 습도가 각각 65%와 77%로 다르다. 세 군집의 예측 표준편차는 0.050∼0.051 A로 서로 같다. 이 결과는 실측 자료와도 이어진다. 세 군집 중심에 가장 가까운 실측 조건은 60℃, 이슬점 50℃, 2 bar에 SR 2.0/3.5와 SR 1.5/2.0이었고, 두 조건의 실측 표준편차는 0.044∼0.054 A로 같은 수준이었다. 채택 비율을 2%나 10%로 바꾸어도 캐소드 SR 2.5 이상인 후보의 비율은 29∼37%, 상대습도의 중심 구간은 59∼83%로 같았다. 군집 수 k를 2에서 6까지 바꾸면, k = 2에서는 채택 집합이 캐소드 SR 2.7 부근과 1.9 부근의 두 유량 계열로 나뉘고, k = 3에서는 낮은 유량 계열이 캐소드 상대습도 65%와 77%의 둘로 갈리며, k = 4 이상에서는 높은 유량 계열도 습도로 갈린 뒤 압력과 SR의 세부 차이로 더 나뉜다. 어느 k에서도 두 SR 계열이 한 군집에 섞이는 일은 없었고, 군집 중심의 예측 표준편차는 0.049∼0.051 A로 같았다. 실루엣 계수는 0.27∼0.31로 낮아 채택 집합은 뚜렷이 떨어진 덩어리들이 아니라 이어진 띠에 가깝고, 군집 중심은 그 띠를 요약하는 대표점이다. k = 3은 두 SR 계열과 함께, 채택 후보의 2/3가 속한 낮은 유량 계열 안의 습도 차이까지 보여 주는 가장 작은 수여서 택했다.
Representative operating conditions of the accepted set
3.4 정방향 재평가와 결정론적 역모델의 비교
Fig. 8(a)는 세 군집 중심 조건의 예측 전류분포이다. 세 분포는 세그먼트 1∼19에서 거의 겹치고 20∼25의 출구 하락도 공유한다. 자료에서 가장 균일했던 실측 분포(σ = 0.040 A, 점선)와 비교하면 입구와 중앙의 진폭은 비슷하고 출구 하락이 조금 더 크다. 이 실측 회차의 조건에 대한 모델 예측이 0.051 A(3.1절)이므로, 모델의 척도에서 세 대표 조건은 실측 최고 조건과 같은 등급이다. 곧 이 자료의 범위 안에서 운전조건으로 지울 수 있는 불균일은 대부분 지워진 상태이고, 남는 것은 유로를 따라 입구에서 출구로 갈수록 전류가 완만하게 줄어드는 기울기이다. 이를 더 줄이려면 운전조건이 아니라 유로 설계나 대향류 배치 같은 셀 설계 변수를 바꿔야 한다.
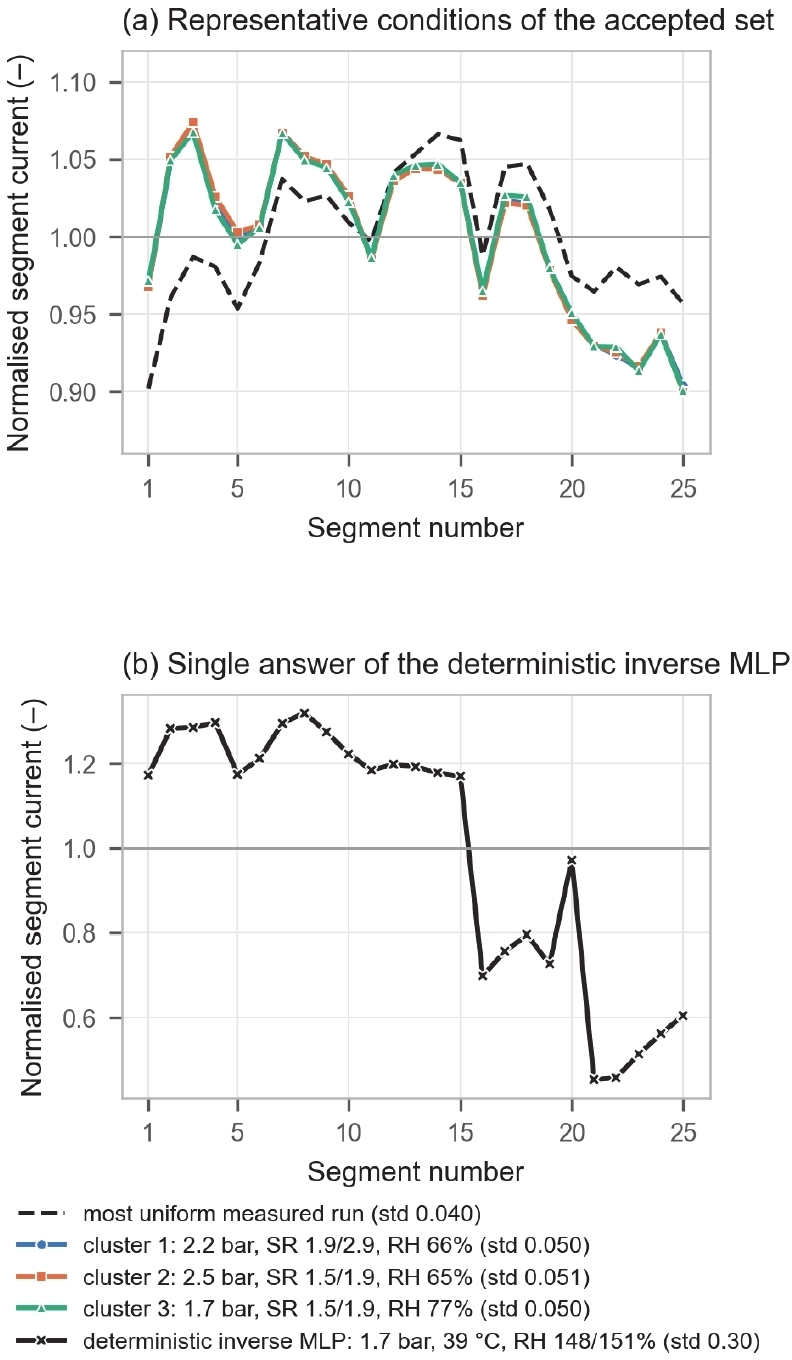
Predicted current distributions of the representative conditions and of the deterministic inverse model
같은 목표를 결정론적 역MLP에 넣으면 1.7 bar, 39℃, SR 1.4/2.2에 애노드와 캐소드 상대습도 148%와 151%라는 조건이 나왔다. 상대습도가 100%를 넘어 물리적으로 존재하지 않는 조건이고, 정방향 모델이 예측한 분포(Fig. 8(b))는 표준편차 0.30 A로 균일과는 거리가 멀다. 완전 균일 분포는 학습 자료 밖의 입력이므로 목표 하나에 조건 하나를 내는 사상은 근거 없이 외삽하며, 출력이 물리적 범위를 벗어나도 이를 걸러 낼 장치가 없다. 본 연구의 절차는 후보를 학습 범위 안으로 제한하고 정방향 모델로 다시 평가하므로 이런 답이 걸러진다.
3.5 방법의 한계
본 연구의 검증은 정방향 모델이 역모델의 답을 평가하는 순환 검증이다. 정방향 모델의 예측 오차(RMS 0.03 A)가 채택 후보 사이의 차이(0.01 A 안팎)보다 크므로, 채택 후보는 순위가 아니라 서로 구별되지 않는 좋은 후보의 집합으로 읽어야 한다. 또한 셀 하나의 특정 상태에서 얻은 189회차의 자료이므로 다른 셀이나 열화된 셀에서는 집합의 위치가 달라질 수 있다. 채택 후보가 학습 상한 60℃에 몰려 있다는 것은 더 높은 온도에서 더 균일한 조건이 있을 수 있음을 뜻하지만, 자료가 없는 영역이라 본 연구에서는 다루지 않았다. 채택 조건이 실제로 같은 균일도를 주는지는 실험으로 확인해야 한다.
4. 결 론
본 연구는 세그먼트 PEMFC 데이터로 균일 전류분포 운전조건을 점이 아닌 집합으로 구하는 절차를 제안하고 적용하였다. 결론은 다음과 같다.
- 1) 운전조건에서 전류분포로 가는 관계는 일대다이다. 189회차의 쌍 17,766개 가운데 조건의 정규화 거리가 0.5를 넘으면서 분포의 RMS 차이가 0.01 A 미만인 쌍이 460개였고, 이 차이는 같은 조건의 반복 측정 차이(중앙값 0.015 A)보다 작다. 따라서 목표 분포 하나에 조건 하나를 내는 역모델로는 답의 범위를 알 수 없다.
- 2) CVAE 역모델로 균일 분포에 대한 후보 40,000개를 만들고 정방향 MLP로 재평가하여 예측 표준편차가 낮은 5%(1,302개)를 채택하였다. 채택 조건은 60℃와 캐소드 상대습도 60∼80%를 공유하면서 압력 1∼3 bar에 걸쳐 있었고, 캐소드 SR은 2 부근과 3 부근의 두 계열로 나뉘었다. 세 대표 조건의 예측 표준편차 0.050∼0.051 A는 자료에서 가장 균일했던 조건에 대한 예측값과 같다.
- 3) 같은 목표를 결정론적 역MLP에 넣으면 상대습도 148%와 151%라는 실현 불가능한 조건이 나왔다. 후보를 학습 범위 안으로 제한하고 정방향 모델로 다시 평가하는 본 절차는 이런 답을 걸러 내면서 해의 집합을 제시한다.
- 4) 정방향 모델의 예측 오차가 후보 간 차이보다 크므로 채택 후보는 서로 구별되지 않는 집합으로 읽어야 하며, 실험 검증과 60℃ 이상 자료의 확보가 향후 과제이다.
Acknowledgments
본 연구성과는 과학기술정보통신부의 재원으로 한국연구재단의 지원을 받아 수행된 연구입니다(RS-2025-02220932). 또한, 산업통상부의 재원으로 한국산업기술기획평가원의 지원을 받아 수행된 연구입니다(RS-2026-25614756).
본 논문의 작성 과정에서 문장 교정 및 구성 검토를 위해 Claude (Anthropic)를 사용하였으며, 저자가 모든 내용을 직접 검토⋅수정하였고 최종 책임은 저자에게 있다.
References
-
L. Peng, H. Shao, D. Qiu, P. Yi, and X. Lai, “Investigation of the non-uniform distribution of current density in commercial-size proton exchange membrane fuel cells”, Journal of Power Sources, Vol. 453, 2020, pp. 227836.
[https://doi.org/10.1016/j.jpowsour.2020.227836]

-
D. Liang, M. Dou, M. Hou, Q. Shen, Z. Shao, and B. Yi, “Behavior of a unit proton exchange membrane fuel cell in a stack under fuel starvation”, Journal of Power Sources, Vol. 196, No. 13, 2011, pp. 5595-5598.
[https://doi.org/10.1016/j.jpowsour.2011.02.064]
-
D. Lee, B. Kim, and S. Lee, “Load variation removal and stack durability experiments to improve lifetime of fuel cell stack for hydrogen electric vehicles”, Journal of Hydrogen and New Energy, Vol. 35, No. 4, 2024, pp. 370-376.
[https://doi.org/10.7316/JHNE.2024.35.4.370]
-
S. J. C. Cleghorn, C. R. Derouin, M. S. Wilson, and S. Gottesfeld, “A printed circuit board approach to measuring current distribution in a fuel cell”, Journal of Applied Electrochemistry, Vol. 28, 1998, pp. 663-672.
[https://doi.org/10.1023/A:1003206513954]
-
Y. G. Yoon, W. Y. Lee, T. H. Yang, G. G. Park, and C. S. Kim, “Current distribution in a single cell of PEMFC”, Journal of Power Sources, Vol. 118, No. 1-2, 2003, pp. 193-199.
[https://doi.org/10.1016/S0378-7753(03)00093-4]
-
D. H. Jeon, K. N. Kim, S. M. Baek, and J. H. Nam, “The effect of relative humidity of the cathode on the performance and the uniformity of PEM fuel cells”, International Journal of Hydrogen Energy, Vol. 36, No. 19, 2011, pp. 12499-12511.
[https://doi.org/10.1016/j.ijhydene.2011.06.136]
-
D. Gerteisen, N. Zamel, C. Sadeler, F. Geiger, V. Ludwig, and C. Hebling, “Effect of operating conditions on current density distribution and high frequency resistance in a segmented PEM fuel cell”, International Journal of Hydrogen Energy, Vol. 37, No. 9, 2012, pp. 7736-7744.
[https://doi.org/10.1016/j.ijhydene.2012.02.024]
-
W. Y. Lee, G. G. Park, T. H. Yang, Y. G. Yoon, and C. S. Kim, “Empirical modeling of polymer electrolyte membrane fuel cell performance using artificial neural networks”, International Journal of Hydrogen Energy, Vol. 29, No. 9, 2004, pp. 961-966.
[https://doi.org/10.1016/j.ijhydene.2003.01.002]
-
J. Lee, I. T. Pineda, V. T. Giap, D. Lee, Y. S. Kim, K. Y. Ahn, and Y. D. Lee, “Performance prediction model of solid oxide fuel cell stack using deep neural network technique”, Transactions of the Korean Hydrogen and New Energy Society, Vol. 31, No. 5, 2020, pp. 436-443.
[https://doi.org/10.7316/KHNES.2020.31.5.436]
-
Y. D. Lee, J. Y. Kim, D. J. Yoo, H. Ju, and H. Kim, “Review of research trend in fuel cell: analysis on fuel-cell-related technologies in electrode, electrolyte, separator plate, stack, system, balance of plant, and diagnosis areas”, Transactions of the Korean Hydrogen and New Energy Society, Vol. 31, No. 6, 2020, pp. 530-545.
[https://doi.org/10.7316/KHNES.2020.31.6.530]
-
J. Y. Park, Y. H. Lee, I. S. Lim, Y. S. Kim, and M. S. Kim, “Prediction of local current distribution in polymer electrolyte membrane fuel cell with artificial neural network”, International Journal of Hydrogen Energy, Vol. 46, No. 39, 2021, pp. 20678-20692.
[https://doi.org/10.1016/j.ijhydene.2021.03.168]